Claude Red: qué es, el repo de GitHub y si es seguro
Un proyecto de GitHub llamado Claude-Red (github.com/SnailSploit/claude-red) ha superado las 6.700 estrellas con una idea sencilla: empaquetar conocimiento especializado de seguridad ofensiva como archivos de «skills» listos para Claude, para que una sesión pueda actuar como un operador de red team con contexto en lugar de un asistente genérico. Es un ejemplo claro de algo que todo líder de seguridad ya debería estar siguiendo: a los asistentes de IA se les puede conectar experiencia de dominio, y la seguridad ofensiva es uno de los dominios que la gente está conectando. Esto no es un recorrido por las técnicas. Trata de la pregunta de gobernanza que plantea el proyecto para quien dirige un equipo de seguridad.
Qué es, al nivel que vale la pena conocer
Claude-Red es una colección gratuita con licencia MIT de 78 archivos «SKILL.md» en 23 categorías. Cada archivo es un prompt estructurado —contexto, terminología, metodología— que da a Claude el contexto especializado para razonar sobre una técnica ofensiva concreta como lo haría un operador formado, en lugar de dar una respuesta genérica. Las categorías abarcan todo un encargo de red team: fallos habituales de aplicaciones web, ataques de identidad y de movimiento lateral, debilidades de nube y contenedores, ingeniería social y técnicas de cadena de suministro y, en el extremo avanzado, el tipo de técnicas de evasión de la detección que separan un ejercicio de aficionado de una simulación de adversario realista. La instalación es simple: clonar los archivos en el directorio local de skills de Claude o pegarlos en un prompt de sistema.
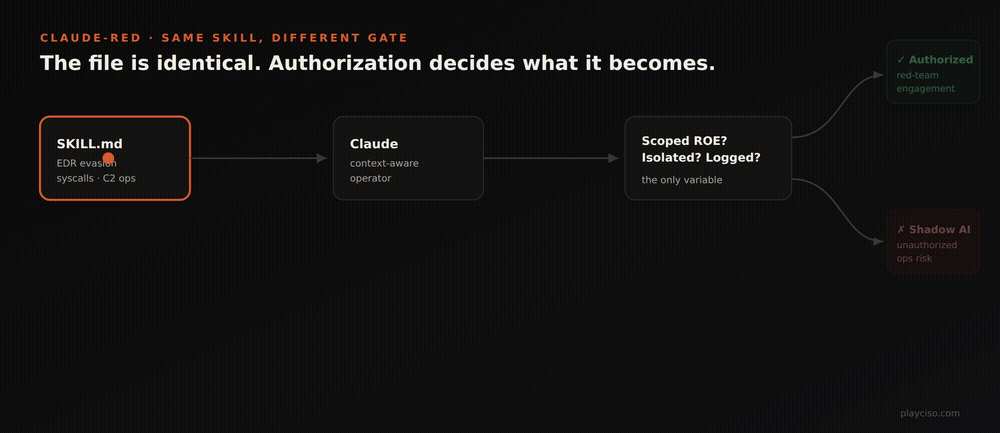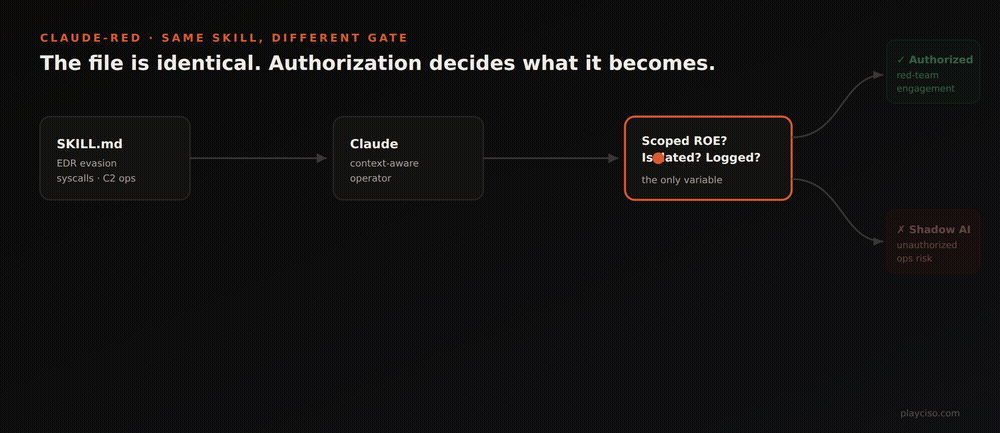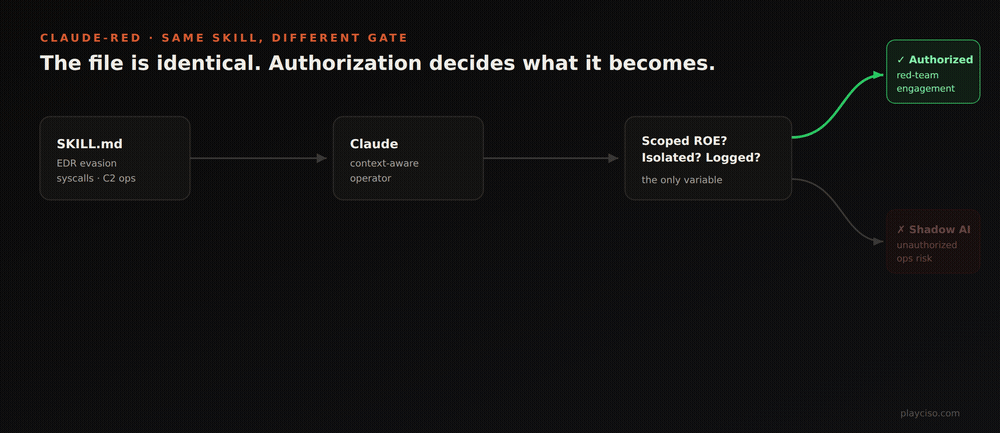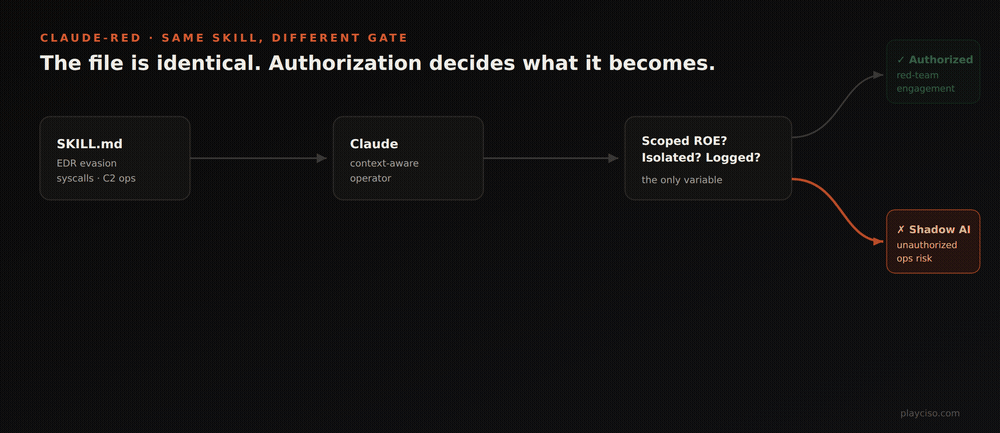
Lo que importa: no hay una puerta integrada
La propia documentación del proyecto menciona primero sus usos previstos: encargos autorizados, triaje de bug bounty, investigación de seguridad, preparación de CTF y formación de operadores. Ese planteamiento es el instinto correcto. Pero indicar un uso previsto en un README es una declaración de política, no un control. Claude-Red no incluye ningún mecanismo que verifique que existe un documento de reglas de enfrentamiento firmado, ninguna comprobación del alcance frente a un objetivo y ningún registro obligatorio antes de invocar una skill. Una vez instalados los archivos, cualquier prompt de esa sesión puede usarlos.
No es una crítica exclusiva de Claude-Red: ningún framework ofensivo de propósito general impone la autorización a nivel de herramienta. Metasploit no revisa tus reglas de enfrentamiento antes de lanzar un módulo de exploit. Cobalt Strike no verifica que tengas un contrato firmado. La frontera de autorización siempre ha estado en el proceso, no en el software. Lo nuevo es quién puede operar ahora a este nivel: un paquete de skills que da a Claude el contexto para razonar como un especialista baja el listón de experiencia necesario para usar técnicas avanzadas, y un asistente de IA tiene muchas más probabilidades que un framework ofensivo independiente de estar ya en la laptop de uso diario de un empleado, junto a su trabajo habitual.
Por qué antes que nada es un problema de IA en la sombra
Para la mayoría de las organizaciones, el riesgo realista no es que un equipo de seguridad decida conscientemente usar herramientas de red team autorizadas: eso ya pasa por un proceso. Es la versión que nadie aprobó: un ingeniero o analista, por curiosidad o para avanzar más rápido en una tarea autorizada, añade un paquete de skills como este a su propia configuración local de Claude. Sin documento de alcance, sin aislamiento, sin registro de la sesión y sin que nadie más en la organización lo sepa. Es el mismo patrón de IA en la sombra que ya preocupa a los equipos de seguridad con las herramientas SaaS de IA no autorizadas y los servidores MCP sin gestionar, solo que aquí la «herramienta no autorizada» trae consigo técnicas ofensivas especializadas.
Un checklist de gobernanza para herramientas ofensivas asistidas por IA
- Primero el inventario. ¿Sabes si alguien de tu equipo ha añadido a su asistente de IA un paquete de skills, un plugin o un servidor MCP con capacidad ofensiva? La mayoría de las organizaciones no puede responder hoy. Empieza por ahí.
- Responsable con nombre y alcance firmado. Cualquier sesión con skills ofensivas cargadas debe corresponder a un encargo concreto y autorizado con un documento de reglas de enfrentamiento: el mismo listón que aplicarías antes de que alguien abra Metasploit.
- Aislamiento. Ejecútalo en un entorno sin ruta a producción y sin acceso a credenciales reales: un laboratorio desechable, no la laptop de uso diario.
- Registro completo de la sesión. Si el paquete de skills no registra, el entorno que lo rodea debe hacerlo: cada prompt y cada acción, conservados para el expediente del encargo.
- Trata los archivos de skills como una cadena de suministro. Los archivos de prompts creados por la comunidad pueden llevar más de lo que anuncian. Revísalos antes de instalarlos, igual que revisarías una nueva dependencia.
- Una política, no solo un memorando. Deja claro que las herramientas de IA con capacidad ofensiva requieren la misma autorización que cualquier otra herramienta ofensiva y que el uso no autorizado es una infracción de la política, no una zona gris.
¿Es seguro usar Claude Red?
Depende de dónde y de quién. Cada skill es un archivo SKILL.md: contexto estructurado de seguridad ofensiva que cambia aquello sobre lo que el asistente razona y lo que sugiere. El riesgo viene de combinar ese contexto con lo que el asistente ya puede hacer, como ejecutar comandos, leer archivos o acceder a la red. Dentro de un encargo autorizado, en una máquina aislada, con registro y un responsable con nombre, es una ayuda de productividad razonable para un red team. En una laptop de desarrollo cualquiera, con acceso a producción y sin alcance, es una capacidad ofensiva sin gestionar. Claude Red es un proyecto de terceros publicado por SnailSploit, no un producto de Anthropic, así que revisa los archivos antes de cargarlos, como harías con cualquier herramienta descargada.
Cómo comprobar si Claude Red está en tus máquinas
- Busca donde viven las skills. Claude Code carga skills desde una carpeta de usuario (
~/.claude/skills/) y desde carpetas de proyecto (.claude/skills/). Busca en endpoints y repositorios archivos SKILL.md y clones de github.com/SnailSploit/claude-red. - Usa la búsqueda de archivos de tu EDR o MDM para el nombre del repositorio y para carpetas de skills en máquinas que no deberían tenerlas.
- Pregunta. Una encuesta breve a los equipos de seguridad e ingeniería sobre qué paquetes de skills y plugins han añadido suele ser más rápida que un escaneo.
- Pon la regla por escrito: paquetes de skills ofensivas solo en hosts de red team aprobados y aislados, con el alcance del encargo adjunto.
La conclusión
Vale la pena conocer Claude-Red aunque tu equipo nunca lo instale, porque es un adelanto claro de una tendencia que no va a desaparecer: los paquetes de dominio especializados, incluida la seguridad ofensiva, se están convirtiendo en una forma normal de ampliar los asistentes de IA. La herramienta en sí es de doble uso y, con una autorización real, un acelerador legítimo para red teams e investigadores. La brecha de gobernanza no es un defecto de este proyecto concreto: es la misma brecha que existe en las herramientas ofensivas en general, solo que ahora llega dentro del asistente de IA en el que tus ingenieros ya confían. Ciérrala con visibilidad y proceso, no con la esperanza de que nadie instale el siguiente.
PlayCISO no está afiliado a Claude-Red ni a su autor. Este artículo es un resumen independiente basado en el README público del proyecto; sus funciones pueden cambiar. Es una pieza de gobernanza y concienciación, no un recorrido por técnicas: deliberadamente no enumera ni explica las técnicas concretas que contienen los archivos de skills. Las técnicas de seguridad ofensiva solo deben usarse con una autorización explícita y documentada.
Preguntas frecuentes
¿Claude Red es un proyecto oficial de Anthropic?
No. Claude Red es un proyecto de terceros en GitHub, publicado por SnailSploit en github.com/SnailSploit/claude-red con licencia MIT. Empaqueta conocimiento de seguridad ofensiva como archivos de skills que Claude puede cargar; Anthropic no lo publicó.
¿Es seguro usar Claude Red?
Solo dentro de un encargo autorizado, en una máquina aislada, con registro de la sesión y un responsable con nombre. Las skills añaden contexto de seguridad ofensiva sin ninguna comprobación integrada de alcance o autorización, así que en una laptop de trabajo normal con acceso a producción se convierten en una capacidad ofensiva sin gestionar.
¿Cómo encuentro Claude Red en los equipos de la empresa?
Busca archivos SKILL.md en los lugares desde los que Claude Code carga skills (~/.claude/skills/ y las carpetas .claude/skills/ de los proyectos), busca clones de github.com/SnailSploit/claude-red con la búsqueda de archivos de tu EDR o MDM y pregunta a los equipos con más probabilidades de usarlo.
¿Qué es Claude-Red?
Claude-Red es un repositorio gratuito y de código abierto (licencia MIT) que empaqueta un gran conjunto de archivos de «skills» de seguridad ofensiva para Claude: prompts estructurados que dan al modelo contexto especializado y conocimiento de técnicas en categorías que van desde vulnerabilidades habituales de aplicaciones web hasta técnicas avanzadas de red team. Ha superado las 6.700 estrellas en GitHub. Instalar los archivos en local convierte una sesión de Claude en un asistente que puede planificar y describir técnicas ofensivas cuando se le pide.
¿Es legal usar una herramienta como Claude-Red?
Tener o instalar los archivos de skills no es ilegal en sí: son texto. Usar las técnicas que describen contra cualquier sistema requiere una autorización explícita y documentada: unas reglas de enfrentamiento firmadas para un encargo de red team o pentest, un programa de bug bounty dentro del alcance, tu propio laboratorio o un CTF. Ejecutar técnicas ofensivas contra un sistema que no es tuyo o que no tienes permiso por escrito para probar es un delito en la mayoría de las jurisdicciones, sea cual sea la herramienta que te ayudó.
¿Claude-Red exige autorización antes de ejecutar una técnica?
No. Como los frameworks ofensivos tradicionales, por ejemplo Metasploit o Cobalt Strike, no tiene ninguna puerta integrada que verifique el alcance, compruebe que existe un encargo firmado o registre lo que se ejecutó antes de usar una skill. El README del proyecto enumera los usos autorizados, pero es una declaración de política en la documentación, no un control impuesto. La comprobación de autorización solo existe si el operador humano, o el proceso de su empleador, la pone.
¿Qué debería hacer realmente un líder de seguridad con herramientas como esta?
Tratar cualquier paquete de skills con capacidad ofensiva igual que instalar Metasploit en una laptop: necesita un responsable con nombre, un alcance documentado, un entorno aislado sin ruta a producción, registro completo de la sesión y aprobación antes de cargarlo en cualquier asistente de IA de un dispositivo de la empresa. El mayor riesgo suele ser la invisibilidad: que alguien añada un paquete de skills a su configuración local de IA sin que nadie más lo sepa. Empieza con un inventario: ¿sabes de verdad qué han añadido tus equipos a sus asistentes de IA de programación y de seguridad?